
เมื่อวานนี้ (4 กุมภาพันธ์ 2026) YouTube ประกาศ อัปเดตครั้งใหญ่ ของฟีเจอร์ Auto Dubbing หรือระบบพากย์เสียงอัตโนมัติด้วย AI โดย “เปิดให้ใช้งานได้กับทุกช่อง” และขยายภาษาที่รองรับเป็น 27 ภาษา เพื่อช่วยให้คอนเทนต์ข้ามกำแพงภาษาได้ง่ายขึ้น ทั้งฝั่งผู้ชม และฝั่งครีเอเตอร์ ที่อยากโตในต่างประเทศ.
ประเด็นสำคัญ คือ YouTube ย้ำว่า การเปิดใช้ Auto Dubbing ไม่ได้ทำให้วิดีโอต้นฉบับ “ถูกลดการมองเห็น” ในระบบแนะนำ (discovery) และยังอาจช่วยให้ถูกค้นเจอในภาษาอื่นมากขึ้นด้วย ขณะเดียวกัน ถ้าครีเอเตอร์ไม่ต้องการ ก็ยัง “ปิดได้” หรือเลือกอัปโหลดเสียงพากย์ของตัวเองแทนได้เช่นเดิม.
Auto Dubbing คืออะไร และมาถึงจุด “เปิดให้ทุกช่อง” ได้อย่างไร
Auto Dubbing คือความสามารถที่ YouTube ใช้ AI ตรวจจับภาษาต้นฉบับ ของวิดีโอ แล้วสร้างเสียงพากย์ในภาษาอื่นให้โดยอัตโนมัติ เพื่อลดอุปสรรคเรื่องภาษา ระหว่างผู้ชมกับครีเอเตอร์.
ก่อนหน้านี้ YouTube เริ่มขยายฟีเจอร์นี้แบบค่อยเป็นค่อยไป เช่น ช่วงปลายปี 2024 YouTube ระบุว่า ได้ทำให้ Auto Dubbing ใช้ได้กับ “หลายแสนช่อง” ในโปรแกรม YouTube Partner Program ที่เน้นคอนเทนต์สายความรู้/ข้อมูล และมีแผนจะขยายไปยังคอนเทนต์ประเภทอื่นต่อไป.
และในปี 2026 นี้ YouTube ก็เดินหน้าต่อ ด้วยการ “เปิดให้ทุกช่อง” เข้าถึงได้ พร้อมอัปเกรดองค์ประกอบสำคัญหลายอย่าง ทั้งคุณภาพเสียง ความเป็นธรรมชาติ และเครื่องมือควบคุมของผู้ชม/ครีเอเตอร์.
Auto Dubbing รองรับ 27 ภาษา ผู้ชมดูได้ง่ายขึ้น ครีเอเตอร์ไปไกลกว่าเดิม
อัปเดตหลักที่สุด คือการรองรับ 27 ภาษา (จากเดิมที่เปิดแบบจำกัดภาษาในระยะแรก) ซึ่งทำให้โอกาสที่ผู้ชมจะเจอ “แทร็กเสียงหลายภาษา” ในวิดีโอเพิ่มขึ้นอย่างชัดเจน.
YouTube ยังยกตัวเลขการใช้งานเพื่อสะท้อนภาพรวมว่า “ในเดือนธันวาคมที่ผ่านมา” แพลตฟอร์มมีผู้ชมเฉลี่ยมากกว่า 6 ล้านคนต่อวัน ที่รับชมคอนเทนต์แบบ autodubbed อย่างน้อย 10 นาที.
วิธีเช็กว่า วิดีโอมีเสียงพากย์ภาษาอื่นไหม
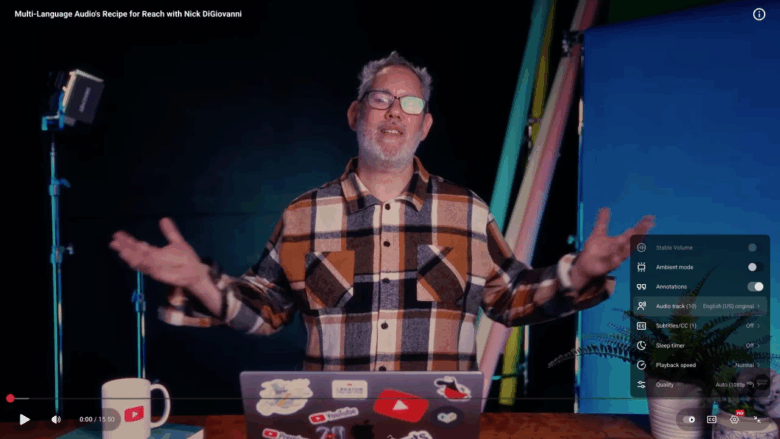
สำหรับผู้ชม วิธีดูง่าย ๆ คือเข้าไปที่วิดีโอ แล้วกดไอคอนรูปเฟือง (Settings) จากนั้นเลือกเมนู Audio track ถ้าวิดีโอนั้นมีเสียงหลายภาษา ก็จะมีรายการภาษาให้เลือก.
Expressive Speech ทำเสียงพากย์ “มีอารมณ์” มากขึ้น ลดความหุ่นยนต์
หนึ่งในข้อจำกัดของการพากย์ด้วย AI คือ แม้คำแปลจะถูกต้อง แต่ “น้ำเสียง” อารมณ์ จังหวะ และบรรยากาศของคลิป อาจไม่ถูกถ่ายทอดได้ครบ จนผู้ชมรู้สึกว่าแข็ง หรือไม่เหมือนต้นฉบับ.
YouTube เลยปล่อยอัปเกรดที่ชื่อ Expressive Speech เพื่อทำให้เสียงพากย์ใกล้เคียงคนจริงขึ้น โดยเริ่มทยอยเปิดให้ทุกช่อง และรองรับ 8 ภาษา ได้แก่ English, Hindi, French, German, Indonesian, Italian, Portuguese และ Spanish.
มองในเชิงประสบการณ์ผู้ชม Expressive Speech คือการพยายามเติม “ความเป็นมนุษย์” ให้เสียงพากย์ เช่น การลงน้ำหนักคำ การลากเสียง การเร่งจังหวะ หรือโทนประโยค ให้สอดคล้องกับอารมณ์ของคลิปมากขึ้น (แม้จะยังไม่สมบูรณ์ 100%).
แล้วต่างจาก Expressive Captions ยังไง
ถ้า Expressive Speech คือการทำ “เสียงพากย์” ให้มีชีวิตขึ้น Expressive Captions คือฝั่ง “คำบรรยาย” ที่เพิ่มสไตล์ เช่น เน้นคำ ใส่โทน หรือสะท้อนอารมณ์ของประโยคในซับไตเติล (คนละแกนกับเสียงพากย์).
Preferred Languages ตั้งค่า “ภาษาโปรด” ได้แล้ว มีผลกับเสียงพากย์ ชื่อคลิป และคำอธิบาย
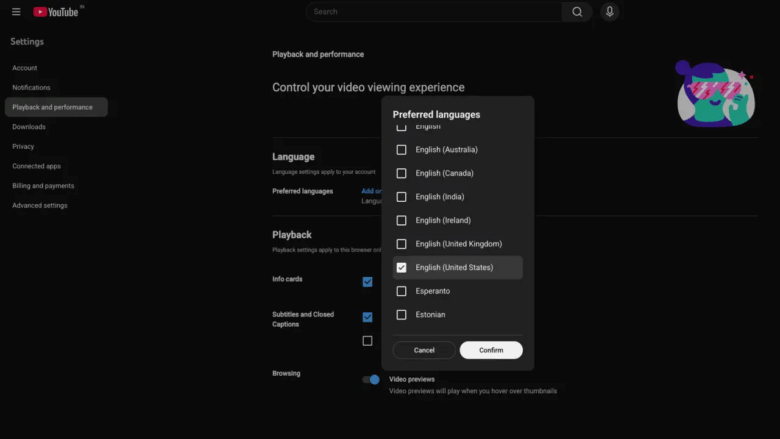
อีกจุดที่อัปเกรด คือการเพิ่มตัวเลือก Preferred Languages ให้ผู้ชม “เลือกภาษาที่อยากดู” ได้เอง โดยตั้งค่าครั้งเดียว แล้วระบบจะนำไปใช้กับเสียงพากย์ (dubs) รวมถึงชื่อคลิป และคำอธิบายด้วย.
ที่สำคัญ YouTube ระบุไว้ชัดว่า ถ้าวิดีโอนั้นมี “เสียงต้นฉบับ” เป็นหนึ่งในภาษาที่ผู้ชมตั้งเป็นภาษาโปรด ระบบจะไม่บังคับใช้เสียงพากย์ AI และจะกลับไปใช้เสียงต้นฉบับเป็นค่าเริ่มต้น เพื่อหลีกเลี่ยงการแปลทับโดยไม่จำเป็น.
วิธีตั้งค่า Preferred Languages (บนคอมพิวเตอร์)
ไปที่ รูปโปรไฟล์ > Settings > Playback & Performance > Language > add or edit languages แล้วเลือกภาษาที่ต้องการ.
วิธีตั้งค่า Preferred Languages (บนมือถือ)
ไปที่ รูปโปรไฟล์ > Settings > Languages > Preferred languages แล้วเลือกภาษา.
Lip Sync ฟีเจอร์ทดลอง ทำปากให้ “ตรงเสียง” มากขึ้นเวลาเป็นคลิปพากย์
YouTube บอกว่า กำลังทดลองฟีเจอร์ใหม่ชื่อ Lip Sync ซึ่งเป็นการ “ปรับการขยับริมฝีปาก” ของผู้พูด ให้เข้ากับเสียงพากย์ที่แปลแล้วแบบเนียน ๆ เพื่อให้คลิปพากย์ดูเป็นธรรมชาติกว่าเดิม (แนวคิดคล้ายทำให้ผู้ชมรู้สึกว่าเจ้าของคลิปพูดภาษานั้นจริง ๆ).
อย่างไรก็ตาม ณ ตอนนี้สถานะยังเป็น “pilot” หรือช่วงทดสอบ จึงอาจยังไม่ครอบคลุมทุกช่อง หรือทุกภาษาในทันที.
เครื่องมือฝั่งครีเอเตอร์: ป้องกันคลิปบางแบบไม่ควรถูกพากย์ และยังคุมได้ว่าจะเปิดหรือปิด
YouTube เพิ่มแนวคิด Automatic Smart Filtering เพื่อช่วยครีเอเตอร์ “คัดกรองอัตโนมัติ” ว่าคลิปแบบไหนไม่ควรถูกพากย์ เช่น มิวสิกวิดีโอ หรือ VLOG เงียบ ๆ ที่เน้นบรรยากาศมากกว่าเสียงพูด เพื่อรักษาความเป็นต้นฉบับ.
และหากครีเอเตอร์ต้องการควบคุมมากกว่านั้น ก็ยังมีทางเลือกหลัก ๆ เช่น
- ตรวจสอบเสียงพากย์ใน YouTube Studio ก่อนเผยแพร่ (review before publishing)
- ยกเลิกการเผยแพร่เสียงพากย์บางภาษา หรือปิด Auto Dubbing ทั้งหมด
จุดนี้สำคัญ เพราะ YouTube เองก็ยอมรับว่าเทคโนโลยียังมีโอกาสพลาด ทั้งด้านความถูกต้องของคำแปล และความเหมือนของน้ำเสียง จึงยังต้องมี “สิทธิ์ตัดสินใจ” อยู่ที่ครีเอเตอร์.
Auto Dubbing ต่างจาก Multi-language Audio ยังไง และควรใช้แบบไหน
หลายคนอาจสับสนระหว่าง Auto Dubbing กับ Multi-language Audio
- Multi-language Audio คือครีเอเตอร์ “อัปโหลดแทร็กเสียงหลายภาษา” ด้วยตัวเอง (เช่น ไปทำสตูดิโอพากย์เอง หรือทำทีมแปลเอง) ซึ่ง YouTube ระบุว่า ได้ขยายไปยัง “ผู้สร้างระดับล้าน ๆ ช่อง” ตั้งแต่ช่วงกันยายน 2025.
- Auto Dubbing คือ YouTube ใช้ AI ทำเสียงพากย์ให้อัตโนมัติ เพื่อให้เริ่มต้นได้ง่าย และใช้แรงน้อยกว่า.
ในเชิงกลยุทธ์ ครีเอเตอร์จำนวนมากอาจเริ่มจาก Auto Dubbing เพื่อทดลองตลาดก่อน แล้วค่อยลงทุนทำเสียงพากย์แบบ manual ในภาษาที่เวิร์กจริง (เพราะ manual มักคุมคุณภาพได้สูงกว่า).
บริบทใหญ่ของปี 2026: YouTube เร่งใช้ AI แต่ก็ต้องคุมความน่าเชื่อถือ และรับมือ “AI slop”
การอัปเกรด Auto Dubbing รอบนี้ อยู่ในภาพใหญ่ที่ YouTube วาง AI เป็นแกนหลักของปี 2026 แต่ในอีกด้านก็ต้องจัดการความเสี่ยงใหม่ ๆ ที่มากับ AI ด้วย
ในจดหมายทิศทางปี 2026 ของ CEO Neal Mohan มีการพูดถึงทั้งเรื่อง “AI transparency & protections” เช่น การติดป้ายกำกับคอนเทนต์สังเคราะห์ การยกระดับเครื่องมือช่วยครีเอเตอร์รับมือ deepfakes และการลดคอนเทนต์คุณภาพต่ำหรือ “AI slop”.
สรุปง่าย ๆ คือ YouTube พยายามเดินสองขาไปพร้อมกัน
- ใช้ AI ทำให้คอนเทนต์เข้าถึงคนได้มากขึ้น (เช่น Auto Dubbing)
- และใช้ AI/กฎ/เครื่องมือ เพื่อกันผลข้างเคียงที่ทำให้แพลตฟอร์มไม่น่าเชื่อถือ (deepfake, spam, AI slop)
สรุป: อัปเดตรอบนี้ ทำให้ Auto Dubbing “ใช้งานจริง” ได้มากขึ้น แต่คุณภาพยังต้องจับตา
การเปิด Auto Dubbing ให้ทุกช่อง พร้อมอัปเกรด Expressive Speech, Preferred Languages และการทดลอง Lip Sync ถือเป็นก้าวใหญ่ของ YouTube ในการทำให้ “ภาษาไม่ใช่กำแพง” สำหรับวิดีโออีกต่อไป.
แต่ในโลกความจริง เสียงพากย์ AI ยังมีโอกาสพลาดอยู่เสมอ โดยเฉพาะคอนเทนต์ที่พึ่งพาอารมณ์ บรรยากาศ หรือมุกเฉพาะภาษา ดังนั้นฝั่งครีเอเตอร์ควรรีวิวคุณภาพก่อนปล่อยจริง และเลือกใช้ให้เหมาะกับประเภทคอนเทนต์ของตัวเอง.
ที่มา: Neowin